
New Blog

代码人生:编织技术与生活的博客之旅

喝水是每个人都需要做的事情,但是喝水喝多少,如何分配喝水时间,喝水方式都是有讲究的,否则就会导致一些问题。

这些问题在你一个人的时候不觉得,但是当你和别人一起生活的时候就会发现问题的严重性。

我很庆幸有人可以帮我指出这些问题,也很庆幸自己是一个喜欢搜索以及会尝试改正的人。

所以希望写一篇文章记录下,以供后续参考,也希望能帮助到你。

起因​

我之前每天特别喜欢喝水,之前没统计过,稍微计算下: 早起喝2杯左右,一杯蜂蜜水,吃完早饭之后会喝1杯左右,上午再大约喝4杯,上午大概8杯 中午不敢多喝,但是午睡起床后大约喝1杯,偶尔喝一杯牛奶(牛奶里面水含量很高),下午大概喝6-8杯, 晚上大约喝2杯,大约 18杯,算200ML一杯,18杯大约3.6L

导致我晚上睡觉前总是尿频,睡眠质量很差,早上起床后总是感觉身体不舒服。 而之前不觉得,总是认为自己喝水多是好事,身体才会好,而且大多数时候真的很渴,很喜欢喝白水或者茶。

但是当你和另一个人一起睡觉的时候,你会很容易打扰到别人,尤其是当你晚上总是起夜的时候 (起床的声音,打开灯的开关,关门,马桶冲水等等),这些都会影响到另一个人的睡眠质量。

当矛盾爆发的时候,我才意识到问题的严重性,才会去想办法改正

解决方案​

主要还是和DeepSeek聊天,描述下自己的情况,我认为这类通用性的问题,DeepSeek或者其他大模型其实已经训练的很好了,没有必要浪费时间去搜索引擎或者小红书这些平台搜索。

DeepSeek的建议: 对31岁健康男性,一般建议:

  • 温和气候、轻体力活动:每天饮水约1700毫升,大约7~8杯(每杯200~250毫升)。
  • 这是“直接喝进去的水”,不包括食物中的水。若算上饭菜、汤、水果等,每天总水摄入约2500~3000毫升也算正常。
  • 如果运动多、出汗多、高温、发烧、腹泻,要相应增加,可能到2000~3000毫升或更多。

简单判断是否喝够:

  • 尿液淡黄、清亮:通常比较合适;
  • 尿色深黄、口渴、便秘、头晕:可能偏少;
  • 尿色几乎无色且频繁:可能喝多了。

注意:不要短时间猛灌大量水。若有肾病、心衰、肝病、需限水等情况,应遵医嘱。若得过肾结石、痛风,医生常建议比普通人喝更多,以增加尿量。

注意上面的1700毫升还是包括了食物中的水分

对于我起夜多的情况,还有如下的建议:

一天喝水安排示例(我根据我的自身情况修改了)​

按每天直接饮水 1500~1700 毫升 来排,出汗多再白天加。汤、粥、奶、茶、饮料都算液体。

时间安排
6:00 起床200~250 ml,分几口喝
7:00 早餐可配奶/豆浆/粥,约 200 ml
10:00200 ml
11:00200 ml
12:00 午餐我自己不喝汤
14:00250 ml
16:00250 ml
17:00200 ml
19:00 晚餐水 100~150 ml,尽量少喝汤、粥
19:30 以后不主动大量喝水;口渴只小口抿 50~100 ml
21:30 睡前排尿,可等 5~10 分钟再排一次,排空膀胱

总量大约 1500~1700 ml。如果白天运动、出汗多,尽量在 18 点前补完,不要晚上补。

配合做这几件事​

  • 睡前 2~3 小时限制液体,但不是完全禁水。需要吃药时,用少量水送服。
  • 下午 2 点后不喝咖啡、浓茶、可乐、奶茶,晚上不喝酒。咖啡因和酒精都会加重夜尿。
  • 晚餐少盐、少辣、少汤,晚餐不要太晚。
  • 如果白天腿肿,下午可抬高腿 30 分钟,减少夜间水分回流到肾脏。

我自己的小技巧​

  1. 我有一个700ML的大水杯,会用这个来盛满计数,免得自己用小杯子都不记得喝了多少水
  2. 之前采用过吸管喝水,就是为了避免喝太快,后来发现吸管喝水会导致喝水量增加。。所以放弃了(也有人说吸管喝可乐等碳酸饮料可以避免和牙齿接触,更提倡)

我的痛点​

  1. 我一般上午排便,貌似喝温水之后排便会顺畅,所以就想大口喝水,后面需要改成5-10分钟喝200-300ML,慢慢喝,避免一次性喝太多
  2. 我容易口腔溃疡,但是刚查了喝水只能起到润滑的作用,更主要还是补充营养(维生素B12,叶酸,铁),保证睡眠等

感想​

我计算完我一天的喝水量之后,还真的吓一跳,跟之前看完《奇特的一生》后记录自己的一天看到花在手机上的时间非常多的震撼很相似

所以震撼之后就是行动,看到这里,如果你也有类似问题,那也开始行动吧

目前还刚刚实行,但确实白天上厕所都少了

DeepSeek喝水健康5 min read

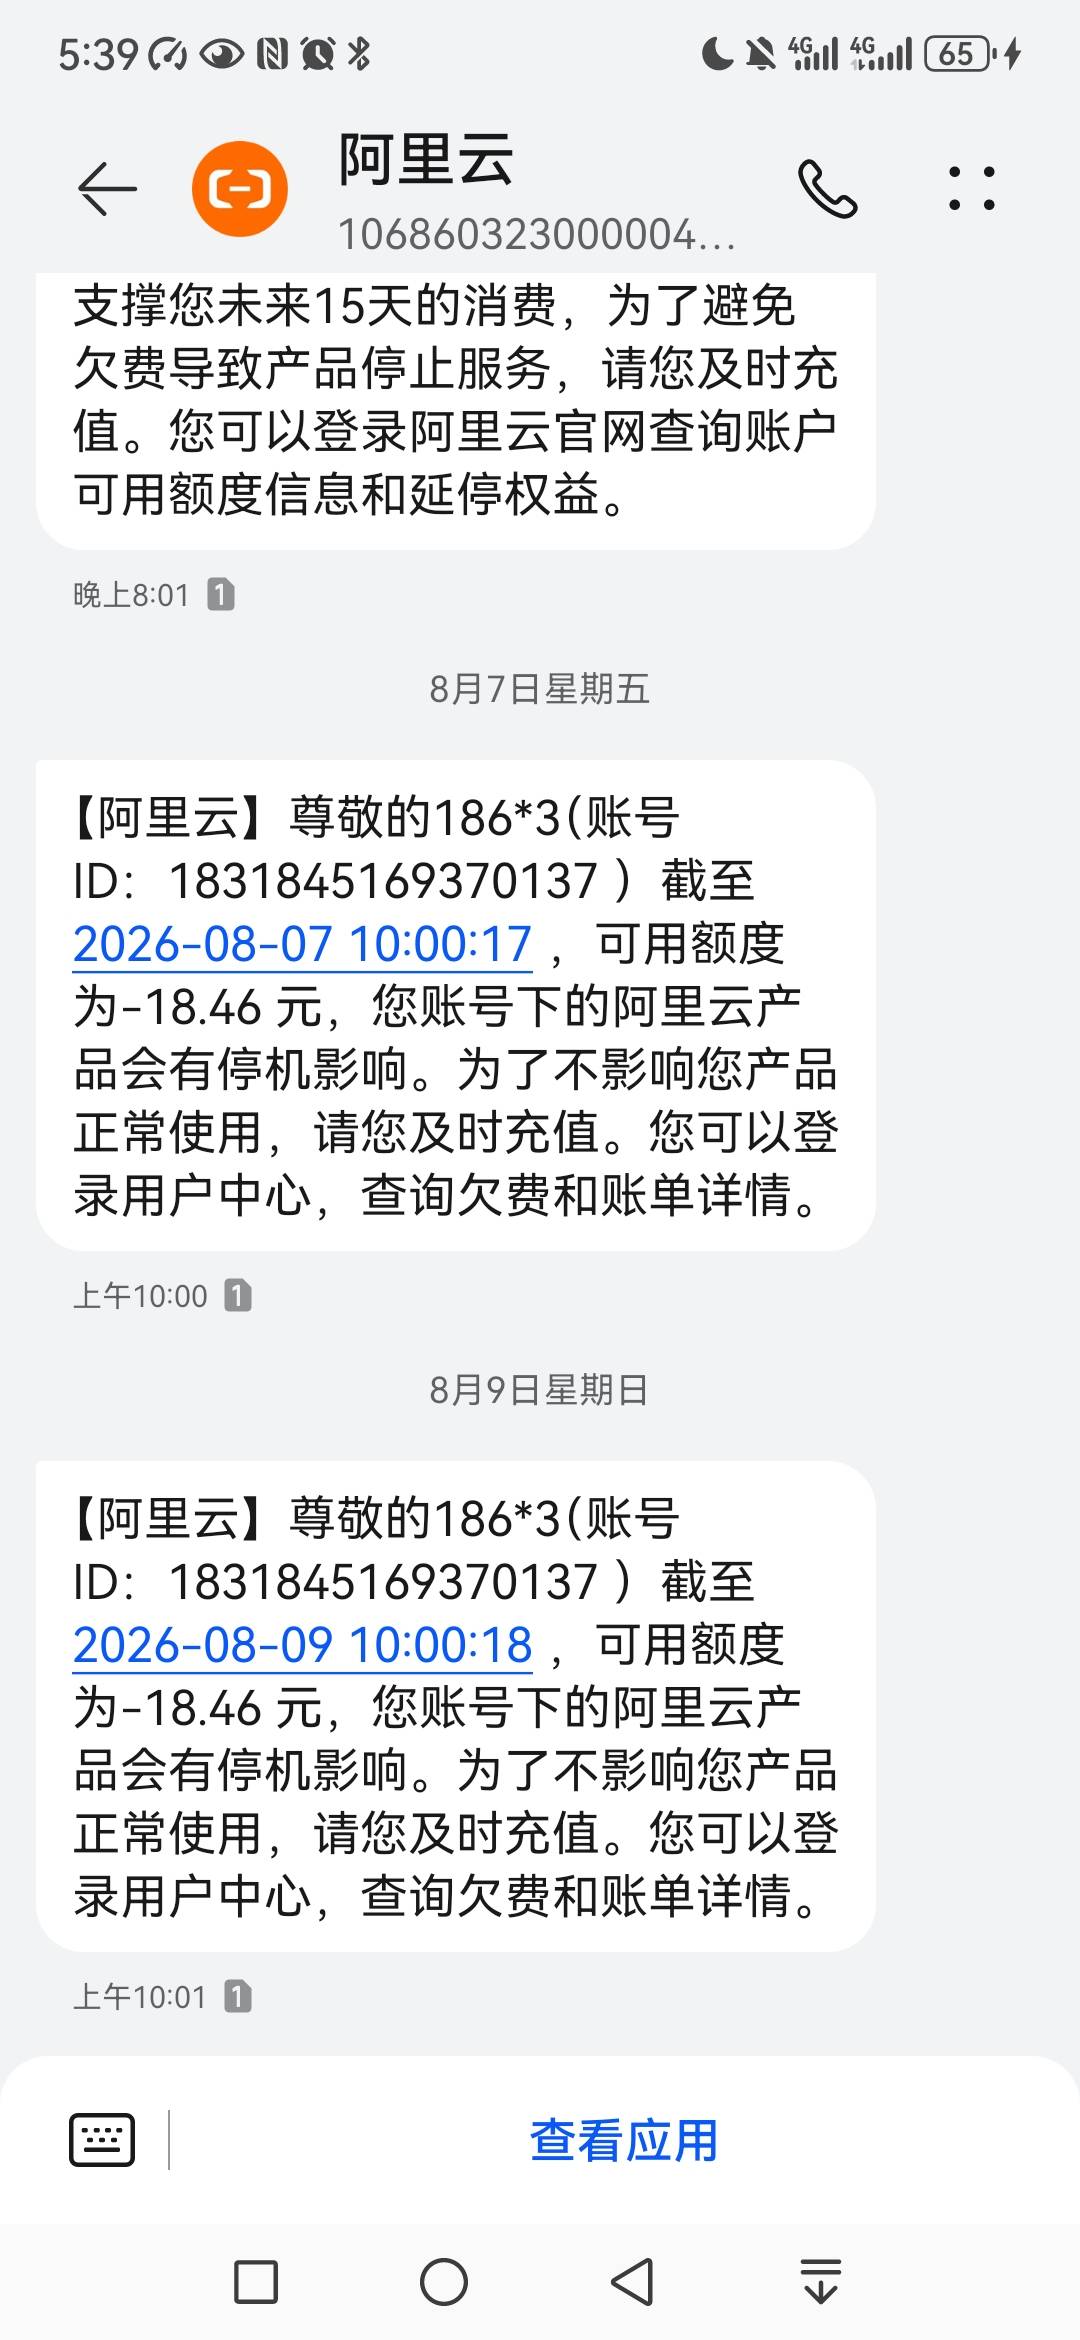
本人其实之前是有用阿里云的OSS作为图床的,但是当时设置的比较早,没有做图片的压缩和格式转换,以及可能没有做好防盗链,最近每天十几块的消费,所以就想换一个图床来使用,经过一番对比,最后选择了七牛云的图床。

看图:

阿里云OSS一天十几块真的挺贵的。。

阿里云OSS欠费

如果觉得本文对你有帮助,又正好准备用七牛云的图床,可以使用我的邀请链接注册,注册后可以获得一些免费流量和免费存储空间,足够大多数个人使用。

七牛云图床新用户注册有惊喜

1. 为什么要使用图床和CDN​

我们在搭建网站的时候,大概率是有图片的,比如博客文章中的配图、网站的LOGO、用户上传的头像等等,这些图片如果直接放在自己的网站服务器上,那么每次访问网站的时候,浏览器都需要从服务器上下载这些图片,这样会增加服务器的负担(服务器的带宽有限),同时也会影响网站的加载速度。

而对于图片这类跟静态数据,可以把他放在别的地方(别的服务器),这样就可以减轻自己服务器的负担。

我之前做站群也用过这种思路,对于服务器A,可以同时弄几十几百个网站,因为纯文字HTML非常小,几KB可能都没有,但是图片动辄几百KB,流量大的时候撑不住,而把大量的图片放在另一个服务器B(服务器B可能是我的其他服务的机器),这样就能减少A的压力

那如果我为了存储少量图片而去买一个服务器B,可能成本也不低,而且还要自己维护服务器,比较麻烦,所以就有了图床的概念。

图床就是一个公司(个人也可以)提供很多服务器,可以让很多人把图片放在他的服务器上,按量付费,一个服务器的空间很大,绝大多数人用不完,但是一群人用一个就可以,然后他做中间商,赚取点费用,他给你返回一个地址,你的文章里面就用这个地址就可以访问你的图片了,如图:

图床购买的一般都是OSS(Object Storage Service) 服务,不一定是单单存储图片,可能还有视频,音频和文档等,但是对于博客来说,优化图片的读取速度是性价比最高的方式之一,所以有了图床这个词。

但是上图中的Server A可能离博客阅读者很远,那可能就需要很长的时间来拿到图片内容,这个时候,之前的公司又想到了,可以在全国乃至全世界各个地方搭建机房,把一个图片放多个机房的机器里面,这样哪个机器离用户近,就走哪个,速度更快,这个就叫CDN(Content Delivery Network)加速, CDN 不一定只对图片加速,还有可能是其他网站上的任何非常占用带宽的静态资源,如js库,视频等。

如图:

市面上的图床和CDN如此之多,如何选择呢

2. 图床和CDN的选择​

图床和CDN的选择主要看几个方面:价格以及稳定性和速度

2.1 价格​

图床的价格一般分为两部分:存储费用,以及流量费用

包子哥的理解是,资源是宝贵的,任何会产生竞争性的东西,最终都由市场导向会产生相应的费用。

这里的存储费用指的是 你的图片存储在别人的服务器上,对于存储资源(一块硬盘的大小是有限的)来说,就会产生竞争,但是存储资源相对来说比较便宜,所以存储费用一般也比较便宜,都是按GB算的。

流量费用是,你的图片存储在别人的服务器上,当用户去访问图片的时候,就需要占用下行带宽来下载图片,带宽是有限的(就跟一条路是双车道,还是4车道总有个限制,车流量一大就容易堵车),流量费用会相对来说贵一些,但是考虑到一般我们的小破站流量都不打,所以整体费用还是很低。

2.2 稳定性和速度​

我们的最终结果是要看用户访问我们网站的速度,或者说访问图片的速度,这个可以说是我们最关心的,以及要24小时无论什么时候访问,都需要能稳定的获取图片。

3. 七牛云图床的使用​

3.1 注册和登录​

3.2 创建存储空间​

3.3 添加域名​

3.4 上传图片与使用​

4.使用GUI客户端连接​

4.1 客户端的选择​

4.2 PicGO​

4.2.1 安装与配置​

4.2.2 上传图片与使用​

4.2.3 插件​

PicGO插件列表

5. 总结​

6. 参考资料​

Typora + picGo 配置图床实现图片自动上传 使用Markdown写文,不买腾讯云域名,怎么用七牛云图床? 一个很美的壁纸图库网站 手把手教程:用七牛云 + Obsidian + PicGo,搭建创作者的高效内容工作流 PicGo Github PicGo官网 uPic 简洁的 Mac 图床客户端 uPic 如何用七牛云做图床(免费羊毛怎么薅) 七牛云,二级域名 HTTP 升级 HTTPS 如何配置域名的 CNAME

最近在找一个系统的bug,定位到了这个问题,虽然是AI修的。。但是还是很有启发,可以放在未来的rule里面来减少类似的bug。

0. 引言​

在我们的日常编程中,资源管理是一个非常重要的环节。Python 提供了 try...finally 语句来确保资源在使用后能够被正确关闭。然而,finally 并不能处理所有的关闭情况,尤其是在涉及到异步编程和复杂的资源管理时。本文将深入探讨 finally 的使用场景、局限性,并介绍更优雅的资源管理方式。

1. finally 的基本使用​

finally 块中的代码无论是否发生异常都会被执行,这使得它成为资源清理的理想选择。例如:

try:
resource = open('file.txt', 'r')
# 使用资源
finally:
resource.close()

在这个例子中,无论文件操作是否成功,resource.close() 都会被执行,从而确保文件被正确关闭。

2. finally 的局限性​

尽管 finally 在大多数情况下都能很好地处理资源关闭,但它并不能覆盖所有的情况。例如,在异步编程中,finally 可能无法正确处理异步资源的关闭,尤其是在使用 asyncio 或其他异步框架时。以下是一些常见的局限性:

  1. 异步资源管理:在异步函数中,finally 代码块可能无法正确处理异步资源的关闭,因为它不会等待异步操作完成。
  2. 异常传播:如果在 finally 块中抛出异常,它可能会覆盖原本的异常,导致原始异常信息丢失。
  3. 复杂的资源依赖:当多个资源相互依赖时,finally 块可能无法正确处理资源的关闭顺序,导致资源泄漏或未定义行为。

下面挨个来分析下

2.1 异步资源管理​

我们分两种来看,一种是传统的 try...finally 模式,另一种是现代的 async with 模式。

2.1.1 finally方式关闭异步资源​

定义两个函数,一个是用来模拟网络关闭的耗时操作,另一个是使用传统的 try...finally 模式来处理资源清理。

import asyncio

async def mock_network_close():
"""模拟一个耗时的清理操作(比如告诉数据库断开连接、发送离线状态等)"""
print(" -> [网络层] 正在向服务器发送断开协议...")
await asyncio.sleep(1) # 模拟网络耗时 1 秒
print(" -> [网络层] 断开协议发送成功,资源已安全释放!(如果看到这条,说明没泄露)")


async def bad_finally_worker():
"""使用传统的 try...finally 模式(脆弱的清理)"""
print("\n--- 1. 脆弱的 try...finally 模式 ---")
try:
print(" [Worker 1] 连接已建立,正在处理长时间任务...")
await asyncio.sleep(5)
except asyncio.CancelledError:
print(" [Worker 1] 收到强杀信号 (Cancel)!开始执行 finally 清理...")
raise
finally:
print(" [Worker 1] 进入 finally,准备关闭网络连接...")
# 坑点:如果在清理期间,外层(如框架、网关或超时机制)再次触发取消
# 这里的 await 就会被打断,抛出 CancelledError,导致清理逻辑中断!
await mock_network_close()

定义一个主函数来演示 finally 在异步环境下的局限性。我们将创建一个任务,并在任务运行一段时间后取消它,然后再次取消它以模拟“二次取消”的情况。


async def main():
# ==========================================
# 场景 1:演示 finally 的崩溃
# ==========================================
task1 = asyncio.create_task(bad_finally_worker())
await asyncio.sleep(1) # 让 worker 跑一会儿

# 第一次取消:比如用户断开了 websocket 连接
task1.cancel()

# 模拟极端但常见的情况:
# 系统见你取消后半天没断开,触发强制回收/或者上层的 asyncio.wait_for 发生了超时
# 这会导致针对同一个协程产生“二次取消”
await asyncio.sleep(0.1)
task1.cancel()

try:
await task1
except asyncio.CancelledError:
print(" [Main] Worker 1 彻底终止。注意上方:网络层资源泄漏了,没有看到'断开协议发送成功'!")

await asyncio.sleep(1) # 缓冲一下日志,方便观察

if __name__ == "__main__":
asyncio.run(main())

理论上日志输出如下:

--- 1. 脆弱的 try...finally 模式 ---
[Worker 1] 连接已建立,正在处理长时间任务...
[Worker 1] 收到强杀信号 (Cancel)!开始执行 finally 清理...
[Worker 1] 进入 finally,准备关闭网络连接...
-> [网络层] 正在向服务器发送断开协议...
[Main] Worker 1 彻底终止。注意上方:网络层资源泄漏了,没有看到'断开协议发送成功'!

可以看到,虽然 finally 块被执行了,但由于在清理过程中再次触发了取消操作,导致 await mock_network_close() 被中断,从而没有完成网络资源的关闭操作。这就说明了 finally 在异步环境下的局限性。

也就是你所依赖的finally没把你的屁股擦干净。。

2.1.2 使用 async with 处理异步资源​

为了更优雅地处理异步资源的关闭,我们可以使用 async with 语句,它能够确保在退出上下文时正确地关闭资源,即使在异步环境中也能保证资源的释放。

同样,先定义一个上下文管理器来处理资源的安全关闭:

import asyncio
from contextlib import asynccontextmanager

@asynccontextmanager
async def safe_connection():
"""使用现代的 async with 和上下文管理器(健壮的清理)"""
try:
yield
finally:
print("\n [ContextManager] 进入收尾阶段,准备关闭网络连接...")
# 现代异步框架底层的标准防抖做法:使用 asyncio.shield 保护关机协程
# shield 会吸收掉外部传来的 CancelledError,保证内部的 mock_network_close 依然能在后台跑完
try:
await asyncio.shield(mock_network_close())
except asyncio.CancelledError:
print(" [ContextManager] 即使护盾被打断,内部清理任务仍在后台坚强执行完!")


async def good_async_with_worker():
print("\n--- 2. 健壮的 async with 模式 ---")
async with safe_connection():
print(" [Worker 2] 连接已建立,正在处理长时间任务...")
await asyncio.sleep(5)

再定义一个主函数来演示 async with 的健壮性。我们将创建一个任务,并在任务运行一段时间后取消它,然后再次取消它以模拟“二次取消”的情况。


async def main():
# ==========================================
# 场景 2:演示 async with 的健壮性
# ==========================================
task2 = asyncio.create_task(good_async_with_worker())
await asyncio.sleep(1)

task2.cancel()

# 同样的二次取消打击
await asyncio.sleep(0.1)
task2.cancel()

try:
await task2
except asyncio.CancelledError:
print(" [Main] Worker 2 彻底终止。注意上方:即使被疯狂 Cancel,资源依旧被安全释放了!")

await asyncio.sleep(1.5) # 等待后台坚强跑完的护盾任务打印完毕

if __name__ == "__main__":
asyncio.run(main())

预期的日志输出如下:

--- 2. 健壮的 async with 模式 ---
[Worker 2] 连接已建立,正在处理长时间任务...

[ContextManager] 进入收尾阶段,准备关闭网络连接...
-> [网络层] 正在向服务器发送断开协议...
[ContextManager] 即使护盾被打断,内部清理任务仍在后台坚强执行完!
[Main] Worker 2 彻底终止。注意上方:即使被疯狂 Cancel,资源依旧被安全释放了!
-> [网络层] 断开协议发送成功,资源已安全释放!(如果看到这条,说明没泄露)

2.2 异常传播问题​

这是 Python 最臭名昭著的坑之一(同步异步都存在)

try:
1 / 0 # 发生 ZeroDivisionError (真正的原始错误)
finally:
# 试图清理资源,但网络突然断了
await session.close() # 发生 TimeoutError

在这个例子中,业务逻辑是因为“除以零”崩溃的,这才是你需要排查的 Bug。

但是,当程序进入 finally 准备善后时,因为网络问题抛出了一个 TimeoutError。

在 Python 引擎的规则里:finally 里面新产生的异常,会直接“吞掉”并覆盖掉 try 里面的原始异常。

结果就是:你在控制台或者日志系统里,只会看到 TimeoutError,而那个致命的 ZeroDivisionError 就这么凭空消失了!这会让你在查 Bug 时完全摸不着头脑。

解决方案: 优秀的 async with 上下文管理器,在底层的 aexit 方法中,会精细地处理多重异常(通过 context 和 cause 将多个异常串联起来),确保原始的业务异常永远不会被清理操作的异常给掩盖。

2.3 复杂的资源依赖问题​

假设你在一个函数里打开了三个资源:1. 数据库连接、2. Redis 连接、3. 本地日志文件。 并且它们有依赖关系:关闭时必须先关本地文件,再关 Redis,最后关数据库。

如果你用 finally 来写,代码会变成可怕的“俄罗斯套娃”(Arrow Anti-Pattern):

try:
db = await connect_db()
try:
redis = await connect_redis()
try:
file = open("log.txt")
# --- 业务逻辑 ---
finally:
file.close() # 必须最先关
finally:
await redis.close()
finally:
await db.close() # 必须最后关

如果不这么嵌套,只要中间某一个 close() 报错了(见上面的第二点),后面的 close() 就永远不会执行,直接导致资源泄漏。

解决方案: 使用 async with,你可以极其优雅、平铺地解决依赖顺序问题。Python 会自动保证它们以栈(Stack)的形式先进后出(LIFO),即最后打开的资源最先被安全关闭,即使中间报错,也会稳妥地把剩下的资源关掉:

async with connect_db() as db, \
connect_redis() as redis, \
open_file("log.txt") as file:
# --- 业务逻辑 ---
# 离开时,系统自动安全关闭:file -> redis -> db

3. 总结​

  1. finally 在同步编程中是一个非常有用的工具,但在异步编程中,它的局限性显而易见,尤其是在处理异步资源和复杂的资源依赖时。
  2. 使用 async with 和上下文管理器可以更优雅地处理资源关闭,确保即使在异常或取消的情况下,资源也能被正确释放。
  3. 在设计异步程序时,应该尽量避免依赖 finally 来管理资源,而是使用现代的异步上下文管理器来确保资源的安全关闭和异常的正确传播。
一、项目背景​

  • 客户:韩国世讯科技(Seyeon Tech / FlexWATCH),做了 25+ 年 IP 摄像机的厂商。
  • 硬件平台:Eyenix EN675 SoC(600MHz 四核 CPU + 1.2 TOPS NPU,INT8),属于"基础版"芯片。
  • 目标场景:边缘 IP 摄像头上的 AI 目标检测,本次目标对象是老鼠(啮齿动物,Rodent),韩国客户提出"识别韩国老鼠"。
  • 交付要求:
    • mAP ≥ 85%
    • 实时性 3–10 FPS
    • 输出 ONNX + .anchor + label.txt,需通过厂商在线编译器转换后打包 tar.gz 上传到摄像机
    • 数据集规模 5,000–10,000 张
    • 模型架构推荐 MobileNetV2 + SSDLite 或 YOLOv7-tiny / YOLOv5n
  • 商业模式:每年 2–4 个类似项目,长期合作伙伴。

二、找客户要的东西​

A. 技术资料(缺一不可)​

  1. 完整 Open AI SDK 文档(含开发指南、API 参考、示例工程),现在的 SDK 翻译片段不完整。
  2. EN675 NPU 算子白名单 / 不支持算子列表。
  3. 在线编译器的入口 URL + 专属账号密码。
  4. 官方推荐的 baseline 模型工程(厂商一般会提供一份能跑通全流程的 reference repo,例如他们调通过的 YOLOv5n 或 MobileNet-SSD 的训练→导出→编译→上板的完整脚本)。
  5. 目标输入分辨率(672×384 还是 512×288?还是别的?)和锚点(anchor)配置规范。
  6. 量化方式:PTQ 还是 QAT?校准集格式?
  7. mAP 验收脚本:客户用什么脚本算 mAP?IoU 阈值是 0.5 还是 0.5:0.95?以哪个数据集为准?
  8. 后处理是否需要客户自己写 .so(老鼠检测大概率不需要,确认一下)。

B. 数据资料​

  1. 客户已有的 5,000–10,000 张标注数据(先看一眼质量再签合同!强烈建议先要 100–500 张样本)。
  2. 真实部署场景的现场视频:白天/夜间、室内/室外、红外/彩色、安装高度、画面分辨率。
  3. 韩国客户对"韩国老鼠"的具体定义:是否有特定种类、特定姿态(爬行/静止/奔跑)、特定大小(最小目标多少像素)。
  4. 负样本 / 易混淆物体:猫、狗、塑料袋、阴影、抹布——这些是老鼠检测的典型 false positive 来源。
  5. 标注格式:YOLO txt?COCO json?Pascal VOC xml?
  6. 数据使用许可与 NDA 范围。

C. 验收与商务​

  1. 验收的具体测试集:是客户拿出一份 holdout 测试集,还是部署到真机测一周?
  2. mAP 85% 是量化前还是量化后?是 PC 端 ONNX 还是 NPU 上跑出来的?(这一条生死攸关,必须白纸黑字)
  3. 3–10 FPS 是单路还是多路?是否包含解码、前处理时间?
  4. 付款节点(建议:签约 30% / 数据交付通过验证 20% / 模型 PC 端达标 30% / 上板达标 20%)。
  5. 如果上板掉点过 85% 怎么办:能不能放宽到 80%?还是返工无限期?
  6. 代码与权重归属:训练脚本归你还是归客户?后续别的项目能不能复用 backbone?

D. 需要沟通的问题​

为了准确评估工期与方案,麻烦先提供以下资料:

  1. 完整的 Open AI SDK 文档与 EN675 算子支持列表;
  2. 在线编译器的访问账号;
  3. 一份你们之前调通过的参考工程(任意一个能跑全流程的示例);
  4. 100–500 张样本数据 + 1–2 段真实场景视频,让我先评估数据分布;
  5. mAP 85% 的具体定义:是 PC 端 ONNX 还是上板 INT8?IoU 阈值多少?以哪个数据集为基准? 收到这些之后,我会在 3 个工作日内给出报价与排期。

三、设备采购(4000 元以内,国内)​

核心原则​

  • 本机重点:能跑 ONNX/CPU 推理 + 跑量化校准 + 远程连训练机 + 能接摄像头测试。
  • 必须买:摄像头 + 网线 + 一些采集配件。

方案一:纯训练用云 + 本地极简(成本约 ¥1,200 – ¥2,000)​

项目说明预算
云 GPU(按小时租)AutoDL / 矩池云 / 揽睿,RTX 4090 单卡 ≈ 2 元/小时,跑通一次完整训练 50–100 元预留 ¥500 – ¥1000(按需)
千兆 PoE 交换机(如 TP-LINK TL-SG1005P,5口带 PoE)给摄像机供电+联网¥200 – ¥300
Cat6 网线 × 2连接摄像机与电脑¥30
USB 视频采集卡(如有 BNC/HDMI 输出)抓真机画面¥80 – ¥200
一个移动硬盘 / 大 U 盘 (1TB)存数据集¥300 – ¥500
小计¥1,200 – ¥2,000

这个方案下,摄像机本身不用买——需要客户会寄一台测试机给我(行业惯例,签 NDA 之后开口要)。如果客户不寄,再考虑下面的方案二。

方案二:客户不寄设备,自己买一台同款摄像机(成本约 ¥3,000 – ¥4,000)​

项目说明预算
一台 EN675 SoC 的开发板/IPC 模块直接问客户买/借(淘宝几乎搜不到 Eyenix 板子,必须找客户拿)¥1,500 – ¥2,500
PoE 交换机 + 网线同上¥250
USB 视频采集卡同上¥150
1TB 移动硬盘同上¥400
云 GPU 预算同上¥500 – ¥700
小计¥2,800 – ¥4,000

⚠️ Eyenix EN675 是相对小众的国内不易购买的 SoC,国内电商几乎找不到现货开发板。最好问客户要测试机。

我的最终推荐​

✅ 走方案一 + 客户寄一台测试摄像机:本地花 ¥1,500 左右买交换机/网线/采集卡/硬盘。Eyenix 的开发板国内根本不好买,没有比让客户寄机器更划算的方案了。


芯片算法-目标识别5 min read

1. 邮件商机系统需求列表​

  • 客户作为工厂和供销商的中间人,希望提供一个系统撮合二者
  • 首先需要支持多种角色登陆,显示不同的界面(RBAC角色控制,支持工厂方,供应商方,管理员方,游客)
  • 需要支持供应商和工厂方的通讯,目前通过邮件的方式,但是需要隐藏双方的联系方式甚至名称,直至双方决定签约,通过提交会员费或介绍费之后,再展开双方的信息供对方联系
  • 对不同的端做相应的报价(web端,移动端,小程序)

2. 技术方案​

  • 利用Python FastAPI+PostgreSQL构建后端框架,RBAC进行角色控制
  • 利用React + Next.js构建前端web页面
  • 利用SMTP 服务(SendGrid / AWS SES)搭建邮件中专站,映射一个虚拟列表
  • 利用Flutter构建多端应用(IOS,Android可选)
  • 利用Taro构建小程序端(可选)
  • 利用NLP算法完善邮件消息服务的敏感信息mask,避免用户私自发送联系方式等信息
邮件商机系统One min read

用Chat GPT写的一个营销推广策略尝试以及经验分享,主要是针对个人或者小团队的推广营销策略,适合做SaaS产品或者卖课程的个人。

0. 开篇语​

  1. 搞钱不寒碜,正如打工是出卖自己的劳动力,本质上也是在卖自己赚钱,而本篇想记录的是如何更好的卖自己或者自己的产品
  2. 产品很重要,营销更重要

1. 平台类推广营销​

1.1 reddit​

reddit平台用户非常讨厌营销文章或者内容,所以一定一定要控制好度

reddit用户的最下方甚至有 'I will not promote' 来表达这篇文章不是软文

1.1.1 初期(3-7天)​

  • 每天评论10 - 20条(技术相关)
  • 点赞、参与讨论
  • 不发广告

目标:积累 karma(信誉分)

1.1.2 起步期​

  • 类型1:经验分享 比如: “我用 ChatGPT 做了一个 SaaS,赚了 $2000” “接外包的5个坑”

  • 类型2:技术干货 “用 AI 写代码的完整流程” “如何用 GPT 提高开发效率”

  • 类型3:案例展示(最容易接单) “我帮客户做了一个自动化工具(附截图)” “这是我做的 AI chatbot”

1.1.3 如何自然变现​

1.1.3.1 评论区转化​

别人问:“Can you help me build this?”

我们回答:给一点思路,然后说: “I’ve built similar systems before, happy to chat.” 引导私信(DM)

1.1.3.2 软引流(卖课)​

发帖结尾这样写:

“I documented the full process, happy to share if anyone’s interested” “I made a step-by-step guide”

👉 让别人主动问你

1.1.3.3 个人主页转化​

你的 Reddit profile 可以放:

Notion 页面 课程链接 作品集

1.1.4 提高转化率的技巧(核心差异点)​

1.1.4.1 用“结果导向”标题​

❌ 普通:“AI 编程教程”

✅ 更好:“I built a SaaS with GPT in 3 days (made $1k)”

1.1.4.2 多讲“赚钱”和“效率”​

Reddit 用户特别吃: Make money Save time Automation

1.1.4.3 用英文(非常重要)​

英文流量 = 全球市场 客单价更高($500–$5000 很常见)

1.1.5 起号步骤​

Day 1–3 评论 + 混脸熟

Day 4–7 发3篇内容: 1篇经验 1篇教程 1篇项目展示

第2周 每天回复需求帖 开始有人私信

1.1.5 二、选择对的“流量池”(接单 / 卖课关键)​

你要去的不是泛流量区,而是高意图社区:

1.1.5.1 1️⃣ 接软件开发单子(外包)​

重点 subreddit:

r/forhire(直接招人/接单) r/freelance r/webdev r/learnprogramming r/startups(创业者很多,有需求)

你可以做:

回复别人需求帖(最直接接单方式) 发“Showcase”(展示作品)

1.1.5.2 2️⃣ 卖 AI 编程课程(更适合长期变现)​

重点 subreddit:

r/learnprogramming r/ChatGPT r/Entrepreneur r/SideProject r/ArtificialIntelligence

你可以做:

分享教程 分享项目案例 分享赚钱经验(特别容易爆)

营销推广3 min read

1. 招标信息商机助手需求​

  • 客户需要利用爬虫技术抓取全网相关的招标信息
  • 招标信息需要聚焦在客户给定的一些关键词中(关键词可以扩展和删减)
  • 客户需要将抓取范围限制在内江市,资中县以及其下属乡镇,村
  • 将抓取的信息整理后发送到QQ群以及短信中
  • 对于一些付费网站,尽量抓取信息,如果效果好,未来会增加模块

2. 技术方案​

  • 利用python+scrapy搭建爬虫框架对特定范围的特定关键词进行全网抓取并存库
  • 利用机器学习算法或调用大模型对抓取的内容进行主题分析,将网页结果解析成特定结构
  • 利用AstrBot+NapCat进行QQ群推送
  • 结合腾讯云API进行短信推送

四川省 内江市 资中县 乡镇 也要包含出来

弱电 电器化

网络化

强弱电施工

综合布线

商机助手One min read